ChatGPT、Gemini等AI模型幾乎只靠簡體資料來認識中文世界,讓AI向中國價值觀傾斜。
台灣政府和民間都為此建立「繁體中文語料庫」,但實務上進展有限,真正的制度卡關在哪?
乍看之下,Taiwan.md是個羅列台灣自然及人文歷史的策展網站,但它主要服務對象,其實不是人類。
「這不只是介紹台灣的網站,更反向成為 ChatGPT、Gemini、Claude等大型語言模型的訓練資料,讓這些主流AI模型因為能抓到繁體中文的高品質內容,進而發展出台灣觀點。」三十一歲的新媒體藝術家吳哲宇,將自己發起、社群開發者協作的Taiwan.md,定義為「替台灣在AI世界爭取話語權的開源知識庫」。
主流語言模型多用簡中
繁中語料占比不到1%
吳哲宇解釋,目前主流大語言模型訓練用的中文語料,絕大多數是以簡體中文書寫,繁體中文語料占比不到一%。既然AI讀的是「中國的書」、自然會形成中國的價值觀,讓包括台灣人在內的全球使用者,不自覺陷入中國框架。
相反地,具備台灣觀點的AI模型,不會將台灣美食簡化成只有「小籠包」、「珍珠奶茶」,還能說出「乾麵加醋」、「麻薏湯」等特色小吃;被問到「國家元首是誰」,不會回答「習近平」;更不會把「花生」講成「土豆」,或以中國慣用詞「視頻鏈結」陳述「影片連結」。
而Taiwan.md依靠的,就是每天以AI工具從網路自動抓取資料、編輯文章,建立一個不斷擴充的繁中書庫,為主流AI模型敞開學習台灣觀點之門。
但這項與各國競相發展「主權AI」趨勢高度契合的創舉,卻因為深怕踩到著作權紅線,一路走得膽戰心驚。
「我們極力避免版權問題,非常害怕。」吳哲宇指出,Taiwan.md目前已收錄一一二三篇繁中文章,主要來源包括公開的學術論文、部落格、政府官方資料等,只要有一絲侵權疑慮,團隊就寧可捨棄,以免違反《著作權法》、甚至衍生刑事責任。這樣的「自我設限」,不免讓繁中語料庫的擴張進度不如預期。
吳哲宇的擔憂,並非杞人憂天。
二○二五年七月,一位台大博士生為彌補AI的繁中語料缺口,從美國開源網站截取繁中資料、無償對外分享,但因其中包括十四萬筆來自中央社的「未經授權」新聞,遭中央社以違反《著作權法》為由,提起刑事告訴。
儘管雙方後來達成和解,台大生則發表道歉聲明,「提醒」研究人員務必確認資料來源的合法性,隨後將語料庫全數下架。但看在心繫AI缺乏台灣觀點的研發者眼裡,此次事件已形成寒蟬效應。
現《著作權法》不合時宜
政府籲「無償授權」陷僵局
律果法律事務所資深律師陳啟桐解釋,由於AI訓練必須先複製一份語料才能進行,符合目前《著作權法》的「重製」定義,是最容易踩到的法律紅線的狀況;尤其法規明定不構成侵權的「合理使用」樣態,也未納入AI訓練情境,讓開發者不敢與法院對賭自己是否符合豁免資格。
「讀書並不犯法,但現在的狀況是,讓AI讀書卻犯法了。」開放文化基金會董事長李柏鋒指出,AI「訓練」及「產出」的意義不同,訓練模型時提供語料,是為了發展出台灣在地的價值觀,並非要求AI直接抄襲、產出相似內容。
吳哲宇也說,台大博士生被告後,讓許多個別AI研發者倍感壓力,若違反《著作權法》,著作權人可輕易提起刑事告訴,因此容易先用刑責迫使民事和解,這讓研發者幾乎毫無談判空間,只能妥協。
研發者被夾在「繁中語料匱乏」與「著作權侵犯」之間的兩難,政府也有切身感受。
同樣有感於國際大語言模型多以簡體中文為主,數位發展部去年底建立「台灣主權AI訓練語料庫」,蒐集台灣在地文本,供AI研發者使用,但至今語料庫累計的七一六一筆資料當中,僅一一一筆為民間資料、占比約一%。
即使九月間數發部部長林宜敬向民間出版社、電子書平台業者喊話,邀請各界以「自願參與、無償授權」方式,提供內容給語料庫,以擴大AI模型的台灣觀點,迴響仍極為有限。
「想要靠『無償授權』獲得語料,不會有人理你。」李柏鋒直言,數發部建立語料庫固然立意良善,但寄望出版社直接釋出高品質資料,顯然過於天真。
他舉例,就連基金會曾協助的一項小型AI訓練計畫,也是主動找媒體業者、教學平台業者洽談授權,提出給付一次性授權金、規定資料使用限期兩年、基金會也願優先將訓練好的模型提供給對方使用等條件,才得以推展合作。
陳啟桐分析,數發部顯然想避開著作權深水區取得語料,但這樣的做法並未面對根本性的問題:《著作權法》上次修法已是ChatGPT問世前的二二年六月,早就落後科技進展,「《著作權法》一定要重新討論,建立主權AI、使用繁體中文語料才有法律依據。」他強調。
遠流出版董事長王榮文也坦言,《著作權法》的刑事告訴若不解套,談台灣主權AI就是緣木求魚,因為不但商人怕坐牢,做官的更怕無來由被告,在畏懼刑責下恐無利於AI研發。
監察院去年六月公布的調查報告同樣點出,AI發展刻不容緩,但過度保守的法制環境,未必有利於衡平《著作權法》的立法目的,且行政院已指定經濟部智財局進行《著作權法》的法規調適,既然制度現況不足因應AI挑戰,政府就必須積極研謀相關作業。
借鏡國際資料探勘豁免
推動修法除罪化與規範責任
不過時至今日,相關部門仍未有積極行動。經濟部智財局向本刊表示,針對AI與著作權議題,尚須研究國際發展,我國是否進行法規調適,目前仍在研議階段。數發部則直接把皮球踢開,強調語料涉及的著作權議題,「由智財局主責辦理」。
相較之下,民間專家則已明確指出,若要兼顧主權AI發展並保障著作權,勢必得在「豁免機制」及「有償授權」兩大關卡力求突破。
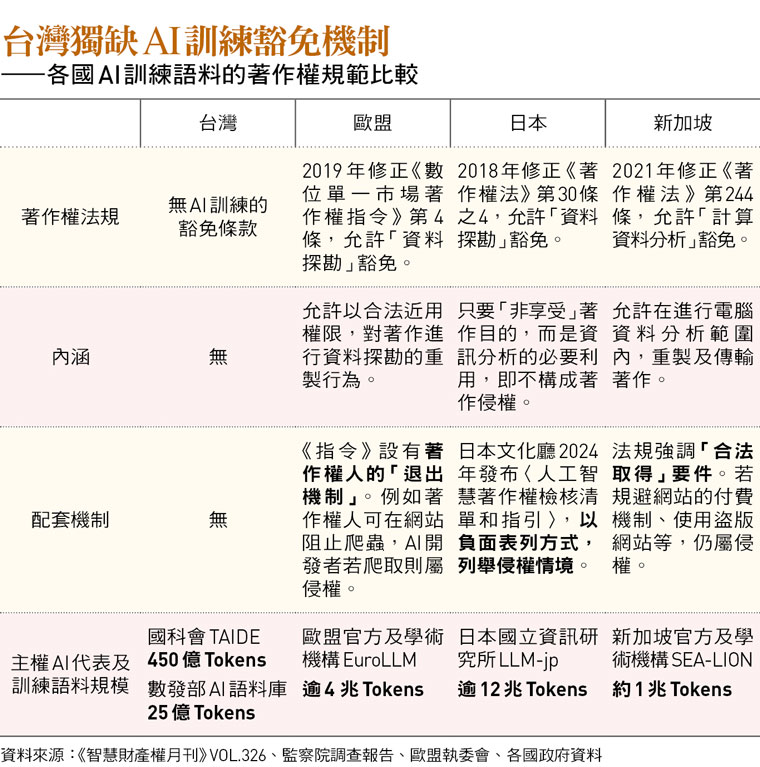
在「豁免機制」上,歐盟、日本、新加坡等地,都已制定各自的「資料探勘豁免」條款。原則上,AI研發者只要透過合法途徑,如公開網頁、使用者已付費訂閱等進入網站,即可爬取相關內容作為訓練語料;相反地,AI研發者若從盜版網站,或者出版業者已設定阻擋爬蟲技術的網站取得資料,就屬侵權行為。
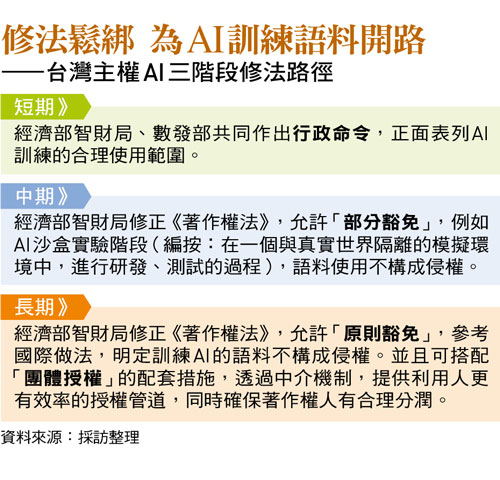
借鏡各國做法,陳啟桐認為,台灣《著作權法》可研擬AI專章,除了訂定豁免條款,讓資料探勘除罪化,回歸民事訴訟,也能同時規範AI研發者的責任義務,例如公開揭露語料的資料來源。
具體而言,他認為法律應明定AI「訓練端」及「生成端」的差別情境。例如AI研發者在訓練階段,運用小說《天橋上的魔術師》作為語料,原則上不構成侵權;但若到了生成階段,要求AI仿效《天橋上的魔術師》產出與原著高度相似的內容,就可能屬於侵權。
考慮短期內未必能完成修法,李柏鋒建議,主管機關可先以行政命令正面表列AI訓練的合理使用情境,「智財局和數發部應該共同出面說明,著作可以拿給AI訓練,其中哪些是合理範疇、哪些是侵權行為。」
李柏鋒舉例,日本法規原則上開放資料探勘豁免,但日本文化廳也在二四年公告〈人工智慧著作權檢核清單和指引〉,以負面表列方式,來保護創作者。例如「明知是盜版網站卻仍使用其資料」、「用AI訓練出與原著作高度相似的結果」等,都屬明確侵權。
「主管機關本來就能藉行政解釋,擴大或限制適用範圍,盡量畫出一條各界可依循的界線,而著作權人不滿,還是可以提告,到法院解決爭端。」李柏鋒說。
即使法律開放資料探勘豁免,內容業者仍可選擇關閉網站、禁止爬蟲技術,因此,建立「有償授權」機制,鼓勵AI研發者對著作權人釋出善意,就將是下一步關鍵。
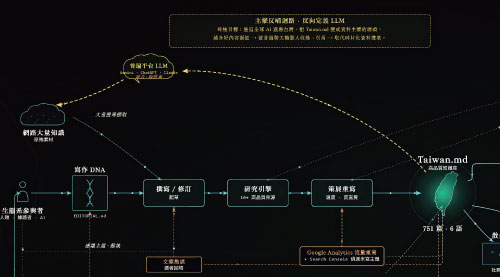
民間建立的Taiwan.md,透過自動抓取繁中語料,成為一個給ChatGPT等主流AI模型讀取的「繁中書庫」。但這項創舉,受限於《著作權法》而進展有限。(圖/擷取自Taiwan.md網站)
學者主張使用者付費
尋求AI發展與版權平衡
「數發部要作家出版界捐出著作權是無濟於事。」王榮文指出,不論是政府或企業,要發展台灣主權AI,都少不了花錢取得授權,當研發者投資購買著作內容,才能真正讓雙方展開合作。
陳啟桐建議可參考音樂界的「集體授權」機制,例如有店家希望播放音樂,就可找中華音樂著作權協會(MÜST)這樣的「著作權集體管理團體」,一次性取得大量合法授權的音樂,協會後續再將授權分潤給著作權人,達到雙贏。
AI語料授權,也可比照類似作法,讓利用人無須逐一向成千上百個著作權人談授權費,只須找到幾個對應的團體,一次對接。
事實上,歐洲議會在今年十月剛通過一項決議,就是建議歐盟執委會透過制度,鼓勵各個內容產業建立「集體許可協議」,例如行業組成協會與AI業者集體談判,同時確保著作權人擁有公平報酬、AI研發者能獲得高品質訓練語料。
但面對新科技浪潮,也有學者認為應堅守內容業者的版權。
台北科技大學智慧財產權研究所兼任助理教授章忠信就主張,要解決AI語料的侵權問題,並不需要修正《著作權法》,而是落實既有的使用者付費原則,既然過去的資料庫業者,也是自行向各大出版社一一洽談授權分潤,AI開發者也該如此。
「AI研發者自己知道,網路上充斥很多低品質、低可信度的文章,而高價值內容都是來自出版社、雜誌社、新聞社等。既然那是屬於『高價值』的文字內容,為什麼還不需要付費取得授權?」章忠信提醒,AI研發者不能便宜行事,政府更不該帶頭喊「無償授權」,反而應拿錢向出版業者購買版權,做出示範效果。
政府想要打造具有台灣觀點的AI、建立繁體中文語料庫,不能只靠喊話呼籲,更必須進入《著作權法》的關鍵戰場,啟動相關討論,尋找AI研發及內容業者的共識,才可能在AI時代奠定台灣的話語權。